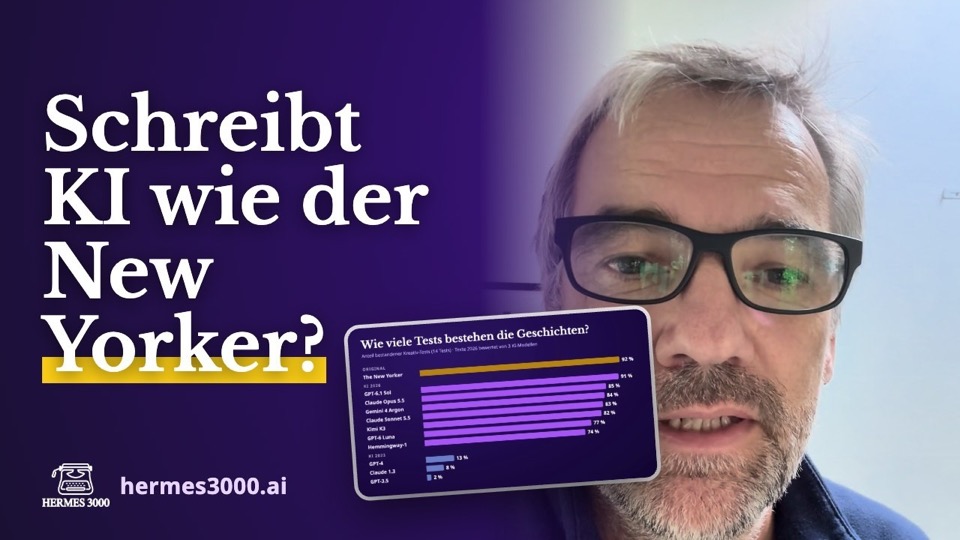
Kurz gesagt: 2023 zeigte eine viel beachtete Studie, dass KI weder gute Geschichten schreiben noch Literatur beurteilen kann. Wir haben sie mit den Modellen von 2026 wiederholt, mit denselben Geschichten, denselben Tests und denselben Expertenurteilen. Das Ergebnis: KI-Geschichten erfüllen heute 77–91 % der Literaturtests statt 2–13 %, GPT-6.1 Sol liegt praktisch gleichauf mit den Originalen aus dem New Yorker. Die KI-Bewerter erkennen inzwischen zuverlässig, ob ein Text Literatur ist, aber nicht, woran es einem einzelnen Text fehlt. Der verbliebene Abstand zwischen Mensch und Maschine heißt Originalität. Stand: 19. Oktober 2026.
Vor ein paar Tagen haben wir hier erzählt, wie wir das Schreibmodell für Hermes 3000 auswählen: mit einem offenen Benchmark, in dem drei KI-Bewerter Texte blind vergleichen. Eine Frage blieb dabei offen, und sie ist unbequem. Wenn eine KI die Texte einer anderen KI beurteilt, woher wissen wir, dass ihr Urteil etwas taugt?
Die Literaturwissenschaft hat darauf eine klare Antwort gegeben, jedenfalls 2023. Wir wollten wissen, ob sie noch stimmt.
Die Studie von 2023: „Art or Artifice?“
Ein Team der Columbia University und von Salesforce Research um Tuhin Chakrabarty hat 2023 untersucht, was KI-Geschichten von guter Literatur unterscheidet (Studie, CHI 2024). Dafür ließen die Forschenden Schriftstellerinnen, Dozenten für kreatives Schreiben und Literaturagenten beschreiben, woran sie gute Prosa erkennen. Daraus entstanden 14 Ja/Nein-Tests, angelehnt an einen klassischen Kreativitätstest (den Torrance Test), in vier Bereichen:
- Sprachfluss: Ist die Geschichte stimmig und verständlich? Stimmt das Tempo? Wird gezeigt statt nur zusammengefasst? Ist das Ende verdient?
- Flexibilität: Wechselt der Text Perspektiven, Stimmungen, Strukturen?
- Originalität: Ist der Gedanke, die Form, das Thema überraschend?
- Ausarbeitung: Sind Figuren entwickelt, ist die Welt sinnlich greifbar, ist die Sprache vielschichtig?
Dann schrieben GPT-3.5, GPT-4 und Claude 1.3 zwölf Geschichten nach den Handlungen echter New-Yorker-Erzählungen, gleich lang wie die Originale. Zehn Experten prüften die 48 Geschichten, jede Geschichte von drei von ihnen, ohne zu wissen, welche von wem stammt. Das Ergebnis war deutlich: Die Originale bestanden 85 % der Tests, die KI-Geschichten 9 bis 30 %. Und als die Forschenden KI-Modelle selbst als Bewerter einsetzten, lagen deren Urteile auf Zufallsniveau.
Das Schöne an der Studie: Die Autoren haben alles veröffentlicht, die Tests, die KI-Geschichten und alle 2.016 Einzelurteile der Experten mit Begründungen. Die zwölf New-Yorker-Geschichten selbst dürfen sie nicht weitergeben; wir haben sie über ein Abonnement für die Auswertung genutzt, sie liegen nicht in unserem Repository.
Schritt 1: Können die KI-Bewerter von heute Literatur beurteilen?
Bevor wir KI-Bewertern trauen, mussten wir sie prüfen. Wir haben unsere drei Bewerter aus dem Benchmark – Claude Opus 5.5, GPT-6.1 Sol und Gemini 4 Argon – dieselben 14 Tests auf dieselben 48 Geschichten anwenden lassen, mit dem Wortlaut der Original-Prompts, und ihre Urteile mit dem Mehrheitsurteil der Experten verglichen. Unser Verfahren gibt für die alten Bewerter der Studie exakt die veröffentlichten Zahlen wieder; wir messen also mit demselben Maßstab.
Auf den ersten Blick ist der Unterschied dramatisch. Die Übereinstimmung mit den Experten, gemessen als κ (0 = Zufall, 0,4 = mittel, 0,6 = deutlich):
| Bewerter | Übereinstimmung mit den Experten |
|---|---|
| GPT-4 (2023) | 0,07 |
| Claude 3 Opus (2024) | 0,13 |
| GPT-6.1 Sol | 0,45 |
| Gemini 4 Argon | 0,60 |
| Claude Opus 5.5 | 0,66 |
Das ist so viel oder mehr, als die Experten untereinander erreichen. Ein so gutes Ergebnis ist verdächtig, also haben wir genauer hingesehen.
Der Großteil davon ist die Unterscheidung Mensch gegen Maschine. Die New-Yorker-Geschichten bestehen bei den Experten rund 90 % der Tests, die KI-Geschichten von 2023 rund 15 %. Die heutigen Bewerter treffen beide Niveaus fast exakt; die alten Bewerter winkten dagegen fast alles durch (Gemini Pro sagte zu 97 % aller Tests „ja“). Schaut man nur innerhalb einer Gruppe – erkennt der Bewerter, welchen Test eine bestimmte Geschichte nicht besteht? –, ist der Fortschritt klein:
| Übereinstimmung pro Test | New-Yorker-Geschichten | KI-Geschichten |
|---|---|---|
| Experten untereinander | 0,41 | 0,22 |
| Heutige KI-Bewerter | 0,14–0,22 | 0,09–0,15 |
Zwei Dinge gehen also heute, eines nicht. Die Bewerter erkennen zuverlässig, auf welchem Niveau ein Text liegt. Und wenn man KI-Geschichten nach der Zahl bestandener Tests ordnet, stimmen sie mit der Expertenmehrheit sogar etwas besser überein als ein einzelner Experte mit den anderen beiden. Welche Schwäche ein einzelner Text hat, können sie dagegen nicht verlässlich sagen. Allerdings sind sich auch die Experten bei schwächeren Texten darin selten einig.
Schritt 2: Schreiben KI-Modelle heute bessere Geschichten?
Jetzt die eigentliche Frage. Wir haben das Experiment von 2023 wiederholt: dieselben zwölf Handlungen, dieselbe Aufgabe („Schreibe eine Geschichte im Stil des New Yorker nach dieser Handlung“), dieselbe Längenanpassung an das Original. Diesmal schrieben die Modelle von 2026, und alle Geschichten – Originale, 2023 und 2026 – wurden von denselben drei Bewertern mit denselben 14 Tests geprüft. Ein Test gilt als bestanden, wenn die Mehrheit der Bewerter zustimmt.
| Geschichten | Anteil bestandener Tests |
|---|---|
| **New Yorker (Originale)** | 92 % |
| GPT-6.1 Sol | 91 % |
| Claude Opus 5.5 | 85 % |
| Gemini 4 Argon | 84 % |
| Claude Sonnet 5.5 | 83 % |
| Kimi K3 (offen) | 82 % |
| GPT-6 Luna | 77 % |
| Hemmingway-1 | 74 % |
| GPT-4 (2023) | 13 % |
| Claude 1.3 (2023) | 8 % |
| GPT-3.5 (2023) | 2 % |
Unsere Bewerter sind strenger als die Experten von damals: Sie geben den Geschichten von 2023 nur 2–13 %, die Experten gaben ihnen 9–30 %. Für den Vergleich spielt das keine Rolle, weil alle Geschichten von denselben Bewertern stammen. Der Sprung bleibt: von einem Zehntel der Tests auf drei Viertel bis fast alle.
Wo der Rest-Abstand liegt. In Sprachfluss und Ausarbeitung erreichen alle Modelle von 2026 über 90 %, so viel wie die Originale. Der Unterschied steckt in der Originalität: Die New-Yorker-Geschichten bestehen 83 % dieser Tests, Sol 72 %, die übrigen Modelle 31–53 %. Die Maschinen schreiben heute handwerklich auf Augenhöhe, aber sie überraschen seltener.
Der Schreibspezialist. Hemmingway-1, ein Modell, das ausdrücklich darauf trainiert wurde, „wie ein Mensch zu schreiben“, landet mit 74 % am Ende des Felds und hat den niedrigsten Wert bei der Originalität (31 %). Es hielt sich außerdem kaum an die Längenvorgabe, auch nach vielen Korrekturrunden nicht.
Haben die Modelle einfach abgeschrieben?
Das war unser erster Verdacht. Die New-Yorker-Geschichten erschienen 2021 bis 2023; ein Modell von 2026 könnte sie beim Training gelesen haben und, mit der Handlung als Stichwort, aus dem Gedächtnis nacherzählen. Das würde einen Sprung erklären, ohne dass die Modelle besser schreiben.
Wir haben deshalb jede Geschichte Wort für Wort mit ihrem Original verglichen:
- Keine einzige Geschichte von 2026 teilt auch nur eine Folge von acht Wörtern mit ihrem Original.
- Die längste gemeinsame Wortfolge ist fünf oder sechs Wörter lang, typische Alltagsformulierungen. Bei den Geschichten von 2023 ist es genauso.
- Gemeinsame Vier-Wort-Folgen machen 0,08–0,22 % eines Textes aus (2023: 0,04–0,05 %).
Die Modelle haben ihre Geschichten selbst geschrieben. Ausschließen lässt sich damit das Nacherzählen aus dem Gedächtnis, nicht aber, dass ein Modell Stil und Bauweise der Originale kennt.
Und die Länge?
Längere Texte bestehen tendenziell mehr Tests, weil mehr Platz für Figuren und Welt ist. Gemini 4, Luna und Hemmingway-1 schrieben trotz wiederholter Aufforderung zu lang. Wir haben die Werte deshalb ein zweites Mal nur mit den Geschichten berechnet, die höchstens 200 Wörter vom Original abweichen. Die Ergebnisse ändern sich um höchstens einen Prozentpunkt, bei Hemmingway-1 um drei. Die Überlänge verschafft keinem Modell einen Vorteil.
Ein Versuch, der nicht funktioniert hat
Wir wollten die Tests auch auf die deutschen Texte aus unserem Benchmark anwenden und dafür einen menschlichen Maßstab danebenlegen: die Anfänge von zwölf deutschen Novellen von Kafka, Musil, Zweig, Fontane, Thomas Mann und Schnitzler, auf dieselbe Länge gekürzt wie die Aufgaben.
Das Ergebnis war überraschend und lehrreich: Auf 300 Wörtern schnitten die Klassiker schlechter ab als die meisten Modelle, obwohl die Bewerter jeden einzelnen Text erkannten. Der Grund liegt im Messinstrument. Die Modelle schrieben abgeschlossene Szenen, die Klassiker liefern Romananfänge, die nach 300 Wörtern noch nichts auflösen müssen. Die Tests belohnen, was eine fertige Geschichte zeigt. Auf Ausschnitten misst dieses Instrument nicht literarische Qualität. Als Vergleichsmaßstab taugen nur vollständige Texte, und genau das haben wir im Experiment mit den New-Yorker-Geschichten getan.
Was wir nicht wissen
Ein Vorbehalt ist uns wichtig. Die Bewerter haben wir nur an New-Yorker-Geschichten und an KI-Geschichten von 2023 überprüft. Die Geschichten von 2026 sind für sie neues Terrain, und die Bewerter sind selbst Modelle von 2026. Es ist denkbar, dass sie den Stil ihrer eigenen Generation höher einschätzen, als menschliche Experten es täten. Ob Expertinnen die besten KI-Geschichten heute wirklich fast auf New-Yorker-Niveau sehen, kann nur ein menschlicher Gegentest klären. Den planen wir als Nächstes in unserer Text-Arena.
Was das für Hermes 3000 bedeutet
- Die Modellwahl hält. Unser Benchmark stützt sich auf genau das, was KI-Bewerter heute gut können: Texte nach Qualität ordnen. GPT-6.1 Sol, für bezahlte Bücher in Hermes verfügbar, liegt auch hier vorn.
- Hinweise statt Urteile. Wenn Hermes eine Passage kommentiert („das Ende wirkt abrupt“), ist das ein Hinweis, kein Befund. Genau diese Art Einzelurteil ist laut Studie unzuverlässig, bei Menschen wie bei Maschinen. Überprüfbares wie Logikbrüche, Zeitfehler oder Perspektivwechsel erkennen die Modelle dagegen gut.
- Originalität bleibt bei dir. Handwerklich können Modelle heute erstaunlich viel. Was sie seltener schaffen, ist das Überraschende: der eigene Gedanke, die ungewöhnliche Form. Das ist der Teil eines Buchs, der von dir kommen muss.
Häufig gestellte Fragen
Können KI-Modelle 2026 Literatur beurteilen?
Teilweise. Sie erkennen zuverlässig, ob ein Text auf dem Niveau professioneller Literatur liegt, und ordnen Texte etwa so gut nach Qualität wie ein einzelner Experte. Welche konkrete Schwäche ein einzelner Text hat, können sie nicht verlässlich benennen.
Schreiben KI-Modelle heute so gut wie Menschen?
Nach unseren Tests erfüllen die besten Modelle von 2026 fast so viele Kriterien guter Kurzgeschichten wie veröffentlichte New-Yorker-Erzählungen; GPT-6.1 Sol 91 % gegenüber 92 %. Der Abstand liegt in der Originalität. Bewertet haben KI-Bewerter; eine Bestätigung durch menschliche Experten steht noch aus.
Haben die Modelle die Originalgeschichten abgeschrieben?
Nein. Keine Geschichte von 2026 teilt eine Folge von acht Wörtern mit ihrem Original, die längste gemeinsame Wortfolge ist fünf bis sechs Wörter lang.
Was ist der Torrance Test of Creative Writing?
Ein Satz von 14 Ja/Nein-Fragen zur Qualität einer Kurzgeschichte in den Bereichen Sprachfluss, Flexibilität, Originalität und Ausarbeitung. Er wurde 2023 von Forschenden der Columbia University und von Salesforce Research gemeinsam mit Schriftstellern und Literaturagenten entwickelt.
Kann ich die Ergebnisse nachprüfen?
Ja. Code, Tests, die KI-Geschichten von 2026, alle Urteile und die Auswertung liegen öffentlich auf GitHub. Nur die New-Yorker-Originale sind aus urheberrechtlichen Gründen nicht enthalten.
Selbst ausprobieren
In Hermes 3000 kannst du in jedem Buch unter ⋮ → KI-Einstellungen in der Modell-Arena mehrere Modelle denselben Satzanfang weiterschreiben lassen und selbst entscheiden, was dir gefällt. Bis 50 Normseiten ist Hermes 3000 kostenlos: Jetzt ausprobieren.